Plataforma y criptografía
Cómo corre un modelo en tu máquina
Qué ocurre entre que lanzas un modelo y aparece la primera palabra en pantalla, contado paso a paso y sin dar nada por sabido. Al final queda claro por qué una tarjeta con cuatro veces menos memoria puede ser seis veces más rápida.
TL;DR
Esta es la primera de dos partes y explica el mecanismo: qué se carga al levantar un modelo, qué hace falta para que salga el primer token, por qué el segundo funciona distinto, y cuál de los tres recursos de la máquina decide la velocidad. La segunda parte es el montaje concreto, pensada para reenviar a quien lo vaya a hacer.
Si diriges seguridad, es probable que hayas tenido que opinar sobre modelos locales sin tener del todo claro qué ocurre dentro de la máquina. Se decide comprar o no comprar una tarjeta de varios miles de dólares con argumentos que vienen de una ficha técnica que nadie sabe leer del todo.
Este artículo recorre lo que pasa entre que lanzas el comando y aparece la segunda palabra en pantalla. No hace falta saber nada de GPUs para seguirlo. Al final quedará claro por qué dos máquinas que cuestan parecido rinden de forma opuesta según lo que les pidas.
Qué significa «correr un modelo en local»#
Un modelo de lenguaje es un archivo. Grande, pero un archivo: una lista enorme de números llamados pesos, que son el resultado del entrenamiento. El de este ejemplo ocupa 18,4 GB.
Correrlo significa tener un proceso que lee ese archivo y hace aritmética con él. Nada más exótico que eso. Puede correr en la CPU de una laptop, solo que muy despacio. La GPU no hace nada cualitativamente distinto: hace lo mismo, mucho más rápido y con mejor acceso a memoria.
Dos palabras que conviene fijar antes de seguir:
- Parámetros
- Cuántos números tiene el modelo. «27B» significa 27.000 millones. Es la medida de su tamaño, y se correlaciona (no siempre) con su capacidad.
- Cuantización
- Con cuántos bits se guarda cada número. En el entrenamiento se usan 16 bits por parámetro; para correrlo se puede bajar a 5 u 8. El modelo pesa menos y pierde algo de precisión. Un 27B a 16 bits ocuparía unos 54 GB; a 5 bits ocupa 18,4.
Esa segunda palabra es la que decide si el modelo cabe en tu máquina, y la veremos aparecer varias veces.
Los primeros segundos: qué se carga y a dónde#
Lanzas el comando y el servidor tarda entre diez y veinticinco segundos en decir que está listo. En ese rato pasan tres cosas, y conviene distinguirlas porque cada una tiene un cuello de botella distinto.
Primero, los pesos suben del disco a la tarjeta. Los 18,4 GB se leen del disco y se copian a la memoria de la GPU, que se llama VRAM. Esta parte la limita la velocidad del disco: en un SSD rápido son unos pocos segundos, y en un disco mecánico sería un minuto largo.
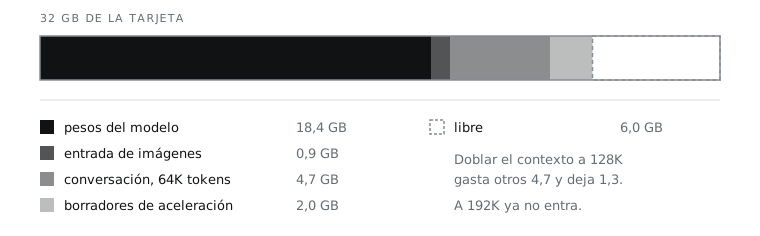
Segundo, se reserva el espacio de la conversación. Esto es lo que casi nadie espera. Además de los pesos, el modelo necesita un espacio de trabajo proporcional a la longitud de la conversación que vaya a soportar. En el ejemplo son otros 4,7 GB reservados por adelantado para 65.000 palabras de contexto. Se reservan aunque no los uses: el proceso los pide al arrancar.
Tercero, se preparan las piezas auxiliares. El diccionario que parte el texto en trozos, la plantilla que da formato a la conversación, y la inicialización de la GPU.
En la práctica
De aquí sale la primera cuenta útil, y la que determina si el proyecto es viable antes de descargar nada:
pesos + espacio de conversación < memoria de la tarjeta
En el ejemplo: 18,4 + 0,9 del componente de imágenes + 4,7 de conversación = 24 GB, en una tarjeta de 32 GB. Cabe con holgura. Si la suma se pasa, no hay ajuste que lo salve, y en la última sección se ve por qué.
El primer token: el recorrido completo#
Escribes una frase y pulsas Enter. Lo que ocurre a continuación tiene cuatro pasos.
Del texto al primer token
- tu frase
- trozos de texto
- números
- una pasada por el modelo
- primer token
Tu frase se parte en piezas. No en palabras: en fragmentos llamados tokens, que a veces son una palabra entera y a veces un trozo. «Inferencia» puede ser dos o tres tokens. Cada fragmento tiene un número asignado en un diccionario fijo.
Cada número se convierte en una lista de números. El modelo no trabaja con identificadores sino con vectores, que son listas de varios miles de decimales donde se codifica el significado aprendido durante el entrenamiento.
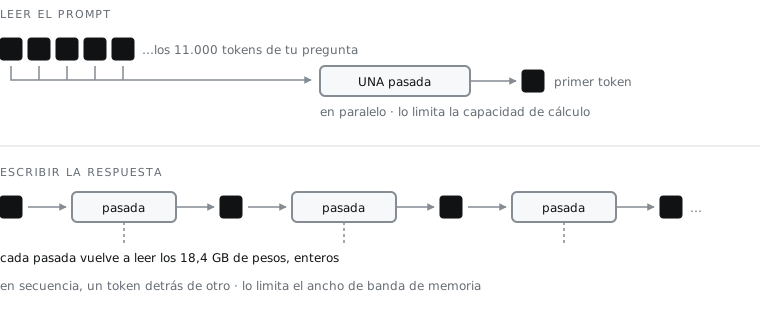
Toda tu frase atraviesa el modelo de una vez. Y esto es importante: el modelo no procesa tu frase palabra por palabra. La procesa entera, en paralelo, en una sola operación matemática muy grande. Por eso un prompt de 11.000 tokens se despacha en unos pocos segundos: no son 11.000 pasos, es un paso con 11.000 cosas dentro.
Sale el primer token. El modelo produce una probabilidad para cada entrada posible del diccionario, y se elige una.
Del primero al segundo: aquí cambia el régimen#
Esta es la parte que explica todo lo demás y la que casi nunca se cuenta.
Para producir el segundo token, el modelo necesita tener en cuenta tu frase entera más el token que acaba de escribir. La forma ingenua sería volver a procesarlo todo desde el principio. Sería ruinoso: el costo crecería con el cuadrado de la longitud.
En su lugar, durante el primer paso el modelo guarda los resultados intermedios de cada fragmento. Para el segundo token solo procesa el fragmento nuevo y consulta lo guardado. Ese almacén es el espacio de conversación que se reservó al arrancar, y es la razón de que la memoria necesaria crezca con la longitud de la charla.
Pero hay un detalle que cambia la aritmética de todo el sistema:
Riesgo
Para producir cada token nuevo, la tarjeta tiene que leer todos los pesos del modelo otra vez. Los 18,4 GB enteros. Para cada palabra que escribe.
No es un fallo de diseño: así funciona la operación. Y de ahí sale, sin más misterio, la fórmula que predice el rendimiento de cualquier máquina.
Es decir: escribir es un proceso secuencial, un token detrás de otro, y cada uno obliga a recorrer el modelo completo. Leer el prompt es un proceso paralelo, todo de una vez. Son dos actividades con cuellos de botella distintos, y confundirlas es el origen de casi todas las malas decisiones de compra.
De qué depende la velocidad#
Tres recursos de la máquina participan. No en partes iguales.
El ancho de banda de memoria#
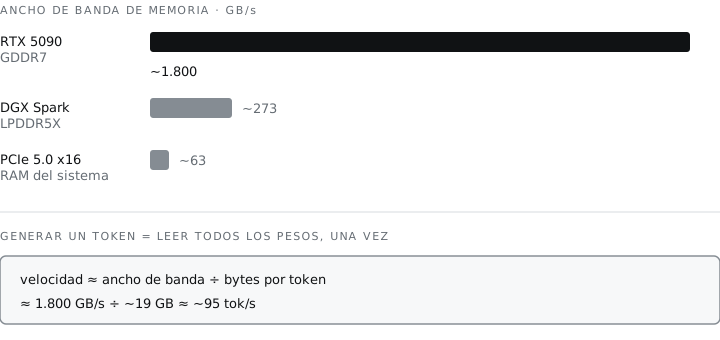
Es cuántos datos por segundo puede leer la tarjeta de su propia memoria. Se mide en gigabytes por segundo y es, con diferencia, el que más manda al escribir.
Si cada token exige leer 18,4 GB, y la tarjeta lee a 1.792 GB/s, el techo es inmediato:
tokens por segundo ≈ ancho de banda ÷ tamaño del modelo
                   ≈   1.792 GB/s    ÷     18,4 GB
                   ≈   97 tokens por segundo
Esa cuenta, con dos datos de la ficha técnica, predice el rendimiento con un error de alrededor del veinte por ciento. Nada más de la máquina importa tanto.
La capacidad de cálculo#
Es cuántas operaciones por segundo puede hacer la tarjeta. Importa mucho al leer el prompt, que es la parte paralela, y casi nada al escribir, que es la parte secuencial.
Durante la escritura, la tarjeta pasa la mayor parte del tiempo esperando datos. Sus unidades de cálculo están ociosas. Por eso dos tarjetas con potencia de cálculo muy distinta pueden generar texto casi a la misma velocidad si tienen el mismo ancho de banda.
El bus y la memoria del sistema#
El bus PCIe conecta la tarjeta con el resto del equipo, y va a unos 63 GB/s. Comparado con los 1.792 GB/s de la memoria de la tarjeta, es una calle estrecha.
Mientras el modelo quepa entero en la VRAM, el bus no interviene: solo se usó al cargar. Pero si no cabe y una parte se queda en la memoria del sistema, esa parte tiene que cruzar la calle estrecha para cada token. No es un diez por ciento peor: es unas treinta veces peor en la porción afectada.
Error común
El error más común al dimensionar es pensar que si el modelo no cabe «irá algo más lento». Va a ir de ochenta tokens por segundo a tres o cuatro. La diferencia entre caber y no caber no es de grado, es de categoría.Dónde queda la CPU#
Casi al margen. Durante la generación con el modelo en la GPU, la CPU se limita a coordinar. Importa al cargar el modelo y en el caso de correrlo solo en CPU, donde pasa a ser el cuello de botella junto con la memoria del sistema, que es entre cinco y veinte veces más lenta que la de una tarjeta gráfica.
Dos máquinas que eligen lo contrario#
Aquí es donde lo anterior se vuelve útil. Comparemos dos equipos que NVIDIA vende para esto mismo y que toman decisiones opuestas.
| RTX 5090 | DGX Spark | |
|---|---|---|
| Memoria | 32 GB GDDR7 | 128 GB LPDDR5X unificada |
| Ancho de banda | 1.792 GB/s | 273 GB/s |
| Procesador | la GPU, en un PC | superchip GB10 con 20 núcleos Arm |
Cuatro veces más memoria en la Spark. Seis veces y media más ancho de banda en la 5090. Son dos respuestas distintas a la misma pregunta, y ninguna es mejor en abstracto.
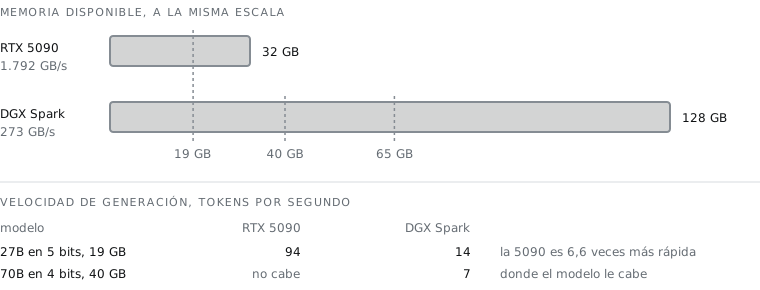
Aplicando la fórmula de arriba a tres tamaños de modelo:
| Modelo | Tamaño | RTX 5090 | DGX Spark |
|---|---|---|---|
| 27B cuantizado a 5 bits | 19 GB | ~94 tok/s | ~14 tok/s |
| 70B cuantizado a 4 bits | 40 GB | no cabe | ~7 tok/s |
| 120B cuantizado a 4 bits | 65 GB | no cabe | ~4 tok/s |
Léela dos veces, porque dice algo poco intuitivo:
Hay modelos que la Spark puede correr y la 5090 no. Los de 70B y 120B sencillamente no entran en 32 GB. En esos casos la comparación no es de velocidad: es que una máquina puede y la otra no.
Y en los modelos que caben en ambas, la 5090 es seis veces más rápida. Para el 27B, 94 tokens por segundo frente a 14. Uno es cómodo para trabajar; el otro se nota.
La Spark corre modelos grandes a velocidad de lectura humana lenta. Cuatro tokens por segundo son unas tres palabras por segundo. Sirve para procesar en lotes, para tareas que no esperas mirando. No sirve para conversar ni para un asistente de código.
No hay, por tanto, una tarjeta mejor. Hay un límite que aprieta primero: o el tamaño del modelo que se necesita, o la velocidad a la que se necesita la respuesta. Cada una de las dos máquinas resuelve uno de los dos problemas y empeora el otro.
Cómo saber cuál es tu caso#
Tres preguntas, en este orden, antes de mirar precios.
¿Qué tamaño de modelo necesitas de verdad? No el mejor disponible: el más pequeño que resuelva tu tarea con calidad suficiente. Para asistencia de código, los modelos de 27B a 32B cuantizados son competentes y caben en 32 GB. Si tu caso exige 70B o más, la decisión ya está tomada y es por capacidad.
¿Alguien va a esperar mirando la respuesta? Si la respuesta es sí, necesitas decenas de tokens por segundo y eso lo da el ancho de banda. Si el trabajo es por lotes y nocturno, cuatro tokens por segundo pueden bastar.
¿Cuántas personas lo van a usar a la vez? Un servidor de inferencia atiende una petición cada vez salvo que se configure lo contrario. Con cinco personas, la velocidad por respuesta importa el doble, porque además hay cola.
Con esas tres respuestas, la fórmula de la sección anterior y la ficha técnica de cualquier tarjeta, se puede estimar el rendimiento antes de gastar nada. Es una cuenta de servilleta y acierta lo suficiente para decidir.
La segunda parte de esta serie es el montaje concreto: qué modelo, qué parámetros, cómo se mide y qué se rompe por el camino. Está escrita para que se la puedas reenviar a quien lo vaya a instalar.