Plataforma y criptografía
Montar un modelo local, paso a paso
El montaje completo de un modelo de 27B en una RTX 5090: qué cuantización cabe y por qué, cada parámetro del arranque explicado, cómo se mide, cómo hacer que suba solo, y la tabla de qué se rompe y cómo se reconoce.
TL;DR
Segunda parte de la serie. La primera explica el mecanismo; esta es el montaje, escrita para seguirla y adaptarla a otra tarjeta. Incluye el cálculo de memoria que hay que hacer antes de descargar nada, los parámetros del servidor uno a uno, la medición con su dispersión real, y el diagnóstico de los seis fallos que aparecen.
Esta es la continuación de cómo corre un modelo en tu máquina, donde está explicado por qué las cosas funcionan como funcionan. Aquí no se vuelve sobre eso: aquí está el montaje.
El resultado es un servidor de inferencia con un modelo de 27.000 millones de parámetros corriendo entero en la memoria de una RTX 5090, accesible desde la red local con una API compatible con OpenAI, y generando a 127 tokens por segundo en tareas de código.
Las cifras son del 29 de septiembre de 2026. Conviene fecharlas porque cambian: las de la medición anterior, con la misma configuración y una versión más antigua del motor, eran 105.
1. Qué cabe, antes de descargar nada#
El primer paso no es instalar: es una resta. Una tarjeta de 32 GB tiene que alojar los pesos, el componente de imágenes y el espacio reservado para la conversación.
| Partida | GB | De dónde sale |
|---|---|---|
| Pesos del modelo, Q5_K_M | 18,4 | tamaño del archivo GGUF |
| Proyector de visión, F16 | 0,9 | tamaño del mmproj |
| Espacio de conversación, 64K | 4,7 | medido por diferencia |
| Subtotal | 24,0 | VRAM sin aceleración de borradores |
| Predicción de varios tokens | 2,0 | diferencia al activarla |
| Total | 26,0 | VRAM medida en uso |
| Holgura | 6,0 |
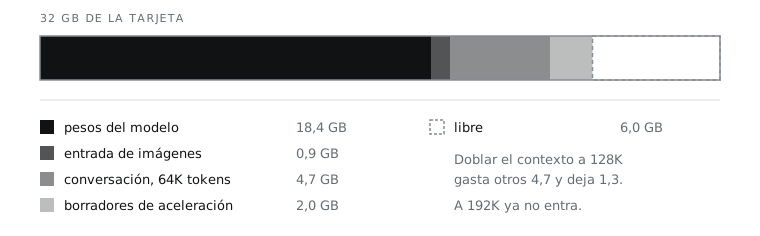
De aquí salen dos reglas que sirven para planificar en cualquier tarjeta:
Cada 1.000 tokens de contexto cuestan unos 72 MB con el almacén de conversación en 8 bits. Es una cota superior: esos 4,7 GB incluyen también las activaciones y el espacio que reserva CUDA, que son fijos.
El techo de cuantización en 32 GB es Q6_K. Con 64K de contexto y la aceleración activada:
| Cuantización | Pesos | Total | ¿Cabe en 32 GB? |
|---|---|---|---|
| Q5_K_M | 18,4 GB | 26,0 GB | sí |
| Q6_K | 22,0 GB | 29,6 GB | justo |
| Q8_0 | ~29 GB | ~36,6 GB | no |
Y la misma cuenta para el contexto, manteniendo Q5_K_M:
| Contexto | Total estimado | ¿Cabe? |
|---|---|---|
| 64K (el elegido) | 26,0 GB | sí |
| 128K | 30,7 GB | justo |
| 192K | 35,4 GB | no |
En la práctica
Haz estas tres tablas para tu tarjeta antes de descargar un archivo de 18 GB. Si el total se pasa de la memoria disponible, la parte que no quepa cae en la memoria del sistema y la velocidad se desploma, por las razones de la primera parte.2. Compilar el motor#
El modelo corre sobre llama.cpp. Los binarios genéricos funcionan, pero se
deja rendimiento en la mesa: hay que compilarlo para la arquitectura concreta de
la tarjeta.
Para la RTX 5090, que es Blackwell, el objetivo es sm_120a. Con CUDA 13.3:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120a \
  -DLLAMA_CURL=OFF
cmake --build build --target llama-server -j "$(nproc)"
Anota el commit con el que compilaste. Cuando una versión nueva rompa algo, y
alguna romperá, git checkout al anterior es la salida rápida.
3. El arranque, parámetro por parámetro#
#!/usr/bin/env bash
set -euo pipefail
ROOT="$HOME/projects/llm-local"
KEY_FILE="$ROOT/.api-key"
[[ -s "$KEY_FILE" ]] || { echo "Falta la API key en $KEY_FILE" >&2; exit 1; }

if pgrep -x llama-server >/dev/null; then
  echo "llama-server ya está corriendo; no se arranca otra instancia." >&2
  exit 0
fi

exec "$ROOT/engine/llama.cpp/build/bin/llama-server" \
  -m "$ROOT/models/Qwen3.8-27B-UD-Q5_K_M.gguf" \
  --mmproj "$ROOT/models/mmproj-F16.gguf" \
  -ngl 999 \
  --ctx-size 65536 \
  --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --host 0.0.0.0 --port 5090 \
  --api-key-file "$KEY_FILE" \
  --load-mode none \
  --alias qwen3-27b \
  --spec-type draft-mtp --spec-draft-n-max 2 \
--jinja| Parámetro | Qué hace | Por qué |
|---|---|---|
-ngl 999 | Manda todas las capas a la GPU | Es la base de todo. Sin esto, parte del modelo se queda en la memoria del sistema |
--ctx-size 65536 | Fija el contexto en 64K | Lo que dice la tabla de arriba que cabe. Subirlo sin recalcular es la vía rápida al desastre |
--flash-attn on | Atención optimizada | Menos tráfico de memoria en la parte que más consume |
--cache-type-k/v q8_0 | Almacén de conversación en 8 bits | Lo reduce a la mitad. Es lo que permite 64K en 4,7 GB |
--load-mode none | Quita el mapeo del archivo | El modelo ya está en la tarjeta; el mapeo en RAM es una copia que nadie lee. Baja de 8,5 GB a 2,8 |
--spec-type draft-mtp | Propone 2 tokens y los verifica | Casi duplica la generación. Cuesta 2 GB de VRAM |
--api-key-file | Lee la clave de un archivo | Ver el apartado 6 |
--jinja | Plantilla de chat oficial | Necesaria para el razonamiento y las llamadas a herramientas |
La comprobación de pgrep de las líneas 7 a 10 no es cosmética. Sin ella, una
segunda instancia intenta reservar otros 26 GB y falla con un mensaje de «sin
memoria en la GPU» que lleva a buscar en el sitio equivocado.
4. Medir#
Sin esto, cualquier cifra es una anécdota.
#!/usr/bin/env bash
set -euo pipefail
PROMPT="${1:?uso: tps.sh \"prompt\" [n_tokens]}"
N="${2:-300}"

curl -s http://127.0.0.1:5090/v1/chat/completions \
  -H "Authorization: Bearer $(cat ~/projects/llm-local/.api-key)" \
  -H 'Content-Type: application/json' \
  -d "$(jq -n --arg p "$PROMPT" --argjson n "$N" \
        '{model:"qwen3-27b", max_tokens:$n, temperature:0.2,
          messages:[{role:"user",content:$p}]}')" \
| jq -r '.timings as $t |
         "generación: \($t.predicted_per_second | floor) tok/s  ·  " +
         "prompt: \($t.prompt_per_second | floor) tok/s  ·  " +
         "tokens: \($t.predicted_n)"'
Tres pasadas seguidas, una función de ordenación en Python, 300 tokens de salida
y temperature 0,2:
| Pasada | Generación | Tokens | Borradores aceptados |
|---|---|---|---|
| 1 | 125 tok/s | 223 | 140 / 166 |
| 2 | 130 tok/s | 231 | 147 / 168 |
| 3 | 127 tok/s | 226 | 141 / 170 |
La columna de la derecha es la que explica el resto. Se acepta el 85 % de los borradores. Con dos propuestas por pasada y esa tasa salen unos 1,7 tokens por cada recorrido completo del modelo, que es exactamente el factor entre los 62 tok/s sin aceleración y estos 127.
Esa es también la cifra a vigilar al cambiar de carga: con prosa creativa y temperatura alta la aceptación cae, y con ella la ganancia, sin que nada parezca haberse roto.
| Medida | Valor |
|---|---|
| VRAM en uso | 26,0 GB |
| RAM del sistema | 2,8 GB |
| GPU bajo carga | ~470 W, 43 °C |
Arranque hasta responder en /health | 11 s |
Error común
Son tres pasadas de una sesión, y la dispersión entre 125 y 130 es la de un prompt fácil. Con otros prompts he visto de 91 a 122. Para comparar hardware o cuantizaciones hacen falta carga fija, repeticiones y percentiles, no una media de tres.Un límite que cambia cómo se reparte#
El servidor atiende una petición a la vez. Las simultáneas se encolan. Para una persona es irrelevante; para un equipo de cinco, la latencia percibida pasa a depender de quién llegó antes.
5. Que suba solo#
El servidor no arranca tras reiniciar, y la solución obvia en Linux no sirve aquí.
Escribir una unidad de systemd parece lo correcto hasta que uno recuerda dos cosas de WSL2: systemd no corre por defecto, y aunque corra, nadie levanta la distribución si nadie la usa. La unidad más elegante del mundo no se ejecuta si la distro está apagada.
Lo que funciona es lanzarlo desde Windows con una tarea programada que, de paso, mantiene la distribución viva:
Nombre      Qwen LLM (llama-server 5090)
Disparador  Al iniciar sesión el usuario, con 20 s de retraso
Acción      conhost.exe --headless wsl.exe -d Ubuntu-24.04 -u <usuario>
              --exec bash -c "exec ~/projects/llm-local/bin/serve.sh"
Límite      Ninguno. Quitar el corte automático de 72 h que Windows
            aplica por defecto a las tareas.
conhost.exe --headless evita la ventana de consola. El exec hace que el
servidor sea el proceso de la tarea, en vez de un hijo que Windows pueda
dejar huérfano.
Riesgo
El límite de este montaje: arranca al iniciar sesión, no al encender. Si la
máquina se reinicia y se queda en la pantalla de bloqueo, el modelo no está
disponible hasta que alguien entre. Y wsl --shutdown apaga todas las
distribuciones y con ellas el servidor, sin avisar a nadie.
Si esto va a dar servicio a un equipo, no lo montes sobre la sesión de escritorio de una persona.
6. La red, que es donde se pierde la tarde#
Dos detalles de WSL2 que cuestan horas si no se saben.
Modo de red espejo#
Por defecto WSL vive tras una NAT y hay que reenviar puertos. Con
networkingMode=mirrored la distribución comparte las interfaces del anfitrión
y el servidor escucha directamente en la IP de la red local:
[wsl2]
networkingMode=mirrored

[experimental]
hostAddressLoopback=true
hostAddressLoopback es la línea que casi nadie pone y la que explica el
síntoma más desconcertante del montaje: desde el propio equipo 127.0.0.1:5090
funciona y la IP de la red local no.
El modo espejo afecta a todas las distribuciones WSL del equipo, incluida la de Docker Desktop. No es un ajuste de una distro.
Hacen falta dos reglas de cortafuegos#
Esta es la que se lleva la tarde. Además del cortafuegos de Windows, el de Hyper-V bloquea por su cuenta lo que entra a la máquina virtual de WSL. Abrir solo la primera deja el puerto aparentemente abierto y mudo desde fuera.
New-NetFirewallRule -Name 'Qwen-LLM-5090' `
  -DisplayName 'Qwen LLM (llama-server 5090, LAN)' `
  -Direction Inbound -Action Allow -Protocol TCP -LocalPort 5090 `
  -RemoteAddress 192.168.0.0/24 -Profile Any

# La segunda, en el cortafuegos de Hyper-V. Sin esta, la primera no basta.
New-NetFirewallHyperVRule -Name 'Qwen-LLM-5090-WSL' `
  -DisplayName 'Qwen LLM WSL (5090, LAN)' `
  -Direction Inbound -VMCreatorId '{40E0AC32-46A5-438A-A0B2-2B479E8F2E90}' `
  -Protocol TCP -LocalPorts 5090 -RemoteAddresses 192.168.0.0/24
Ambas limitadas a la subred local, nunca a cualquier origen. Sustituye el rango por el tuyo.
7. La clave y lo que protege#
La clave se lee de un archivo, no se pasa en la línea de comandos:
umask 077
printf 'qwen-%s\n' "$(openssl rand -hex 12)" > ~/projects/llm-local/.api-key
El motivo es concreto. Con --api-key "$VARIABLE", el intérprete resuelve la
variable antes de lanzar el proceso, así que la clave queda en la línea de
comandos y cualquier usuario local la lee con ps aux. Con --api-key-file se
lee en tiempo de ejecución y no aparece en la tabla de procesos.
Conviene tener claro qué cubre esa clave:
Cubre que alguien de la red use la GPU sin permiso.
No cubre nada más. No hay usuarios, ni permisos por usuario, ni límite de peticiones, ni registro de qué se preguntó. Si la clave se filtra, lo único que queda son las reglas de cortafuegos. Por eso están limitadas a la subred, y por eso la clave debe ser de esta máquina y no reutilizada de otro montaje.
Rotarla son tres líneas:
umask 077
printf 'qwen-%s\n' "$(openssl rand -hex 12)" > ~/projects/llm-local/.api-key
pkill -x llama-server    # la tarea programada lo vuelve a levantar
Después hay que actualizarla en todos los clientes, que es el motivo real por el que nadie rota nada.
Riesgo
Lo anterior vale para un servidor que solo responde texto. Si conectas un agente que ejecuta comandos, el problema es otro y mucho mayor: en la práctica es ejecución remota de código gobernada por un modelo. No lo expongas a la red y ponlo en un contenedor con lo mínimo. Merece su propio artículo y lo tendrá.8. Qué se rompe y cómo se reconoce#
La tabla que hubiera querido tener el primer día.
| Síntoma | Causa probable | Qué hacer |
|---|---|---|
| No responde tras reiniciar el equipo | Nadie ha iniciado sesión, o la tarea aún no ha corrido | Iniciar sesión y esperar los 20 s. Si sigue, lanzar la tarea a mano y mirar el log |
| Desde otro equipo da tiempo de espera agotado | Falta la regla de Hyper-V, el cliente no está en la subred, o una VPN bloquea la red local | Comprobar las dos reglas, la IP del cliente, y la opción de red local de la VPN |
| Responde 401 | Clave incorrecta o cabecera mal formada | Authorization: Bearer y la clave, sin comillas sobrantes |
En el propio equipo 127.0.0.1 va y la IP de LAN no | Falta hostAddressLoopback=true | Añadirlo, wsl --shutdown y relanzar |
| El log dice que no hay memoria en la GPU | Otra instancia, u otro programa, ocupa la VRAM | nvidia-smi para ver quién. Suele ser una segunda copia del propio servidor |
| El servidor se cayó solo | Alguien ejecutó wsl --shutdown o cerró la sesión de Windows | Relanzar la tarea |
| Las respuestas tardan en empezar | El modelo razona antes de contestar | Es normal. Se desactiva por petición con "chat_template_kwargs": {"enable_thinking": false} |
En la práctica
Dos detalles del modelo que ahorran confusión al integrarlo: el razonamiento llega en un camporeasoning_content separado del contenido, y el servidor
acepta imágenes porque carga el proyector de visión. Ambas cosas sorprenden a
quien conecta un cliente esperando una respuesta plana.Mantenimiento#
Actualizar el motor, que es lo que más cambia:
pkill -x llama-server
cd ~/projects/llm-local/engine/llama.cpp
git pull && cmake --build build --target llama-server -j "$(nproc)"
La compilación reutiliza la configuración de CUDA guardada en build/. Si una
versión nueva rompe algo, el commit anterior está en git log.
El disco virtual de WSL crece con las descargas y no se reduce solo. Conviene
revisarlo con df -h / de vez en cuando, sobre todo si pruebas varias
cuantizaciones.