Plataforma y criptografía
Un LLM capaz sin que tus datos salgan de la red
Monté Qwen3.8-27B en una RTX 5090 y llegué a 105 tokens por segundo generando código, con el modelo entero en VRAM y sin que una sola consulta cruzara internet. Esto es lo que costó y lo que hay que vigilar.
TL;DR
Un modelo de 27B cuantizado a Q5 cabe entero en 32 GB de VRAM y genera a ~105 tok/s, suficiente para trabajo real. La velocidad no la fija el cómputo sino el ancho de banda de memoria, y por eso todo el modelo tiene que estar en la GPU. La parte que nadie cuenta es la de seguridad: un agente de terminal conectado a ese modelo ejecuta código sin sandbox.
Todo equipo de seguridad que ha prohibido pegar código en un chatbot público se ha encontrado después con la pregunta incómoda: entonces, ¿qué usamos? Durante dos años la respuesta honesta era «nada equivalente». Eso cambió.
Monté un modelo de 27 000 millones de parámetros en una sola tarjeta de consumo y llegué a 105 tokens por segundo generando código. Ninguna consulta sale de la red. Lo que sigue es el detalle de cómo, y la parte de seguridad que casi nadie incluye.
Para el directorio
Traducción para un comité: por el precio de unas pocas licencias anuales de asistente comercial, se obtiene capacidad equivalente para tareas de código con cero exposición de datos a terceros. El argumento no es el ahorro: es que desaparece toda una categoría de riesgo de fuga.Lo que se montó#
Compilar el motor para la arquitectura correcta
llama.cppcompilado con CUDA 13.3 y destinosm_120. Usar los binarios genéricos cuesta rendimiento desde el primer token.Modelo entero en VRAM
Qwen3.8-27B cuantizado a Q5_K_M: 18,4 GB de pesos más 0,9 GB de visión, en una tarjeta de 32 GB. Cabe con sitio para 64K de contexto.Primera medición: 62 tok/s
Funcional, pero por debajo del techo teórico. Aquí es donde la mayoría se detiene y concluye que lo local no compite.MTP: +67% sin perder calidad
La decodificación especulativa con las cabezas del propio modelo sube la generación a una media de 105 tok/s a cambio de 2 GB de VRAM.
Por qué la velocidad depende de la memoria y no del cómputo#
Este es el concepto que ordena todas las decisiones y el que casi nadie explica bien. Para producir cada token, la GPU tiene que leer todos los pesos activos del modelo, una vez. La generación no está limitada por la potencia de cálculo: está limitada por cuántos datos por segundo puede leer de su memoria.
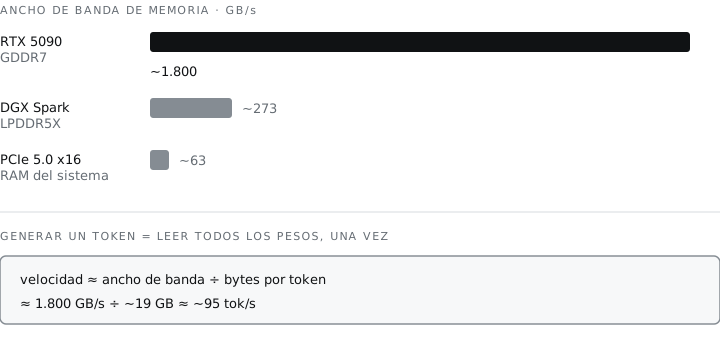
La aritmética es directa:
velocidad ≈ ancho de banda ÷ bytes por token
          ≈  1.800 GB/s     ÷    ~19 GB
          ≈  ~95 tok/s   (techo teórico)
Medimos ~62 sin optimizar y ~105 con MTP, por encima del techo «teórico» porque MTP produce varios tokens por cada lectura de pesos.
En la práctica
De esa fórmula salen todas las optimizaciones, y todas hacen lo mismo: mover menos datos por token. Cuantizar reduce los bytes. Meter todo en VRAM cambia la carretera. MTP amortiza cada lectura entre varios tokens.Lo que cada ajuste aporta#
| Ajuste | Efecto | Por qué funciona |
|---|---|---|
| Todas las capas en GPU | Base de todo | Evita cruzar el PCIe hacia la RAM |
| Cuantización Q5_K_M | ~3× menos bytes por token | La generación es memory-bound |
| Flash Attention + caché KV en 8 bits | Menos tráfico, más contexto | Libera VRAM para la ventana |
Compilar para sm_120 | Kernels óptimos | Evita rutas genéricas más lentas |
Sin mmap | RAM del sistema 8,5 → 1,3 GB | El modelo ya está en VRAM; el mapeo sobra |
| MTP | +67 % de generación | Varios tokens por cada pasada de pesos |
La configuración#
llama-server \
  -m models/Qwen3.8-27B-UD-Q5_K_M.gguf \
  --mmproj models/mmproj-F16.gguf \
  -ngl 999 \
  --ctx-size 65536 \
  --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --host 0.0.0.0 --port 5090 \
  --api-key "$LLM_API_KEY" \
  --load-mode none \
  --alias qwen3-27b \
  --spec-type draft-mtp --spec-draft-n-max 2 \
  --jinja
Las líneas resaltadas son las que mueven la aguja: todas las capas en la GPU, el contexto de 64K y la decodificación especulativa.
Error común
Fíjate en que la clave va en una variable de entorno, no escrita en el fichero. En mi primera versión estaba en claro dentro del script, que además vive en un repositorio. Es el error de siempre, cometido por alguien que se dedica a señalarlo.Lo medido#
| Configuración | Generación | Prompt | VRAM |
|---|---|---|---|
| Base | 61–65 tok/s | 100–3.000+ tok/s | 24,2 GB |
| Con MTP | 91 · 122 · 103 (media 105) | 100–3.000+ tok/s | 26,3 GB |
Bajo carga: ~80 % de uso de GPU, 515 W, 55 °C. Un prompt de 11 000 tokens se procesó en 3,7 segundos.1
La parte de seguridad que nadie escribe#
Aquí es donde un informe de ingeniería se convierte en un problema de gobierno. Montar el modelo es la parte fácil.
| Insignificante | Menor | Moderado | Mayor | |
|---|---|---|---|---|
| Casi seguro | Media | Alta | Crítica | Crítica |
| Probable | Baja | Media | Alta | Crítica, posición de este caso |
| Posible | Baja | Media | Media | Alta |
| Improbable | Baja | Baja | Media | Alta |
El modelo en sí es inofensivo: es un proceso que escucha en un puerto. El riesgo entra con lo que le conectas. Un agente de código de terminal ejecuta comandos en tu máquina sin caja de arena. Esa es su gracia y también su peligro.
Riesgo
Un agente con capacidad de ejecución es, en la práctica, ejecución remota de código gobernada por un modelo estadístico. No lo expongas a la red. El propio proyecto de uno de los agentes que probé bloquea a propósito esa exposición, y tienen toda la razón.Lo que aplicaría en cualquier organización antes de repartir esto a un equipo:
- Hecho: Clave de API obligatoria en el servidor de inferencia
- Hecho: Regla de cortafuegos limitada a la subred, nunca a toda la red
- Hecho: Credenciales en variables de entorno, jamás en los scripts
- Pendiente: Caja de arena para el agente de código: pendiente, y es lo importante
- Pendiente: Registro de lo que el agente ejecuta, para poder auditarlo después
Prohibir la herramienta pública sin ofrecer una alternativa no reduce el riesgo: lo mueve al teléfono personal, donde ya no lo ves.
Qué haría distinto#
- Empezar por el sandbox, no por la velocidad. Pasé la tarde optimizando tokens por segundo y dejé para «luego» la caja de arena del agente. El orden correcto es el inverso: lo lento y seguro se puede acelerar, lo rápido e inseguro hay que rehacerlo.
- Escribir el
systemdel primer día. El servidor no arranca solo tras un reinicio. Un servicio que depende de que alguien se acuerde no es un servicio. - Medir con varias pasadas. Las cifras de una sesión sirven para decidir, no para presentar.
Lección aprendida
La conversación sobre IA y fuga de datos lleva dos años estancada en «prohibir o aceptar». Hay una tercera opción y ahora cabe en una tarjeta gráfica. El trabajo del CISO no es elegir entre las dos primeras: es saber que existe la tercera y cuánto cuesta sostenerla.Cifras de una sola sesión, no medianas de varias pasadas. MTP rinde más con contenido predecible (código) y temperatura baja. Con prosa creativa la ganancia cae bastante. ↩︎